Промпт-инжиниринг для кода сводится к трём вещам, на которых сходятся официальные гайды Anthropic, OpenAI и Google: конкретная задача (файл, симптом, критерий «готово»), проверка с ответом «прошло / не прошло» (тест, сборка, линтер) и постоянный контекст проекта в файле вроде CLAUDE.md. Ниже — что именно пишет каждая документация, пары промптов «было → стало» и шаблоны для агентов и function calling.
Обновлено 31 октября 2026 года. Все цитаты и примеры сверены с документацией на эту дату, ссылки на первоисточники — в каждом разделе.
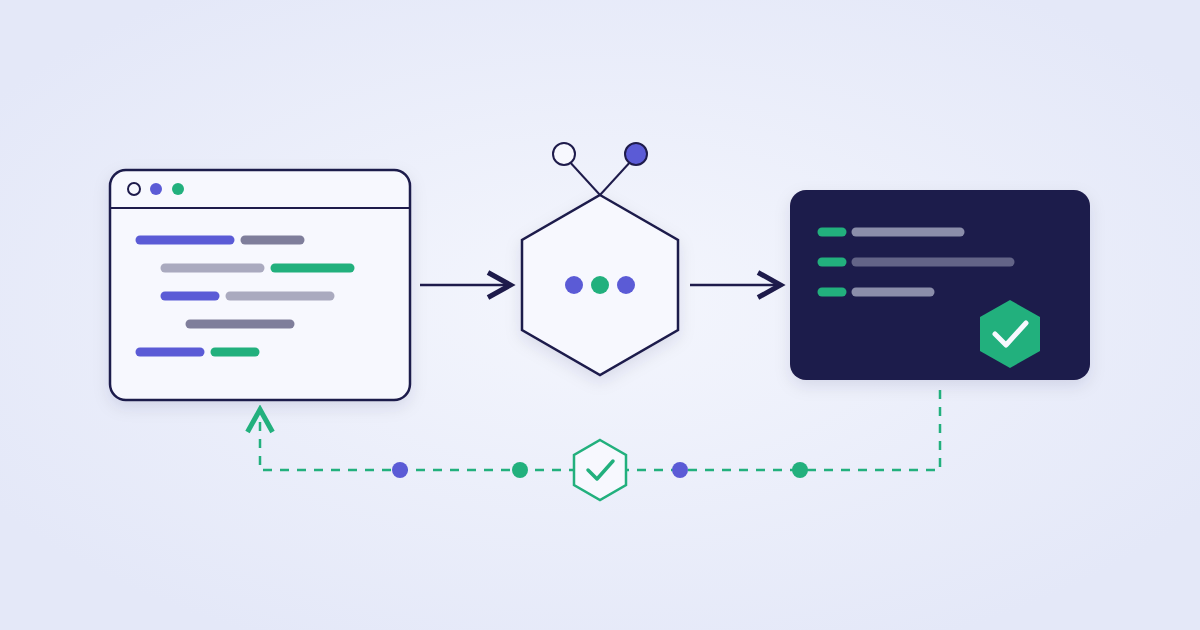
Цикл промпта для кода: агент сам повторяет правку и проверку, пока результат не пройдёт, и показывает вывод команды.
Что говорят три официальных гайда о промптах для кода
Все три компании публикуют свои рекомендации открыто, и в главном они совпадают: модели нужна конкретная задача, способ проверить результат и контекст, которого нет в коде. Различаются акценты. Anthropic пишет больше всех, потому что Claude Code — отдельный продукт со своей документацией. OpenAI держит советы по коду в одном разделе гайда, Google — в общих принципах промптинга для Gemini.
Промпты для кода в официальной документации (сверено 31.10.2026)
Вопрос
Anthropic (Claude, Claude Code)
OpenAI
Google (Gemini)
Как ставить задачу
Назвать файл, описать симптом, сказать, как выглядит «исправлено»
Задать модели роль агента-инженера с понятными обязанностями
Точно и прямо, без лишних и «убеждающих» слов
Проверка
Тест, сборка, линтер или скриншот; просить команду и её вывод
Проверять изменения юнит-тестами, перепроверять применённые патчи
Инструмент code execution для любых вычислений и подсчётов
Постоянный контекст
Короткий CLAUDE.md, правила по папкам, навыки (skills)
Инструкции разработчика в сообщении developer или параметре instructions
Файл GEMINI.md в Gemini CLI, имя можно сменить на AGENTS.md
Длинный код и документы
Документы в начале промпта, вопрос в конце
Контекст обычно лучше ставить ближе к концу промпта
Сначала весь контекст, инструкции и вопрос в самом конце
Глубина рассуждения
Уровень effort; «думай шаг за шагом» — обычный текст
Рассуждающим моделям хватает цели верхнего уровня
Для сложных задач может помочь «Think very hard before answering»
Источники: Best practices for Claude Code, Anthropic Prompting best practices, OpenAI Prompt engineering, Google Prompt design strategies.
Как сформулировать задачу: пары «было → стало» из документации
Конкретный промпт работает лучше, потому что даёт агенту информацию, которой в репозитории нет. Anthropic формулирует это так: если сразу назвать файл, описать симптом и сказать, как выглядит «исправлено», обычно экономишь один круг исправлений. Два примера ниже взяты из документации Claude Code, третий — из общего гайда Anthropic по промптингу.
Было:
почини баг с логином

Стало:
пользователи сообщают, что вход ломается после истечения сессии. посмотри обновление токена в src/auth/, напиши падающий тест, который воспроизводит баг, потом исправь его
Было:
добавь виджет календаря

Стало:
повтори паттерн из HotDogWidget.php и сделай виджет календаря, где можно выбрать месяц и листать годы. без новых библиотек
Было (Claude только предложит правки):
Можешь предложить изменения, чтобы улучшить эту функцию?

Стало (Claude внесёт правки):
Измени эту функцию, чтобы повысить её производительность.
Готовое лучше описания. Файл подключается через @ и путь, скриншот макета или ошибки вставляется прямо в промпт, вывод команды передаётся конвейером: cat error.log | claude -p "what's going on here".
Объём работы называйте сами. Claude склонен читать запрос консервативно и делать минимальную версию. Если нужна полная, документация советует фразу «be ambitious» и перечисление: пустые состояния и ошибки, сохранение, навигация с клавиатуры.
Если задача ещё не ясна, попросите агента взять у вас интервью: «задавай вопросы, пока не сможешь написать спецификацию, потом запиши её в SPEC.md». Сборку Anthropic советует начинать в новой сессии с чистым контекстом и готовым определением «сделано».
Для разведки подойдёт и размытый промпт вроде «что бы ты улучшил в этом файле?» — правок по ходу будет больше, и это осознанный размен.
Проверка результата: тест, сборка, линтер и доказательства
Главный совет Anthropic по коду: дайте агенту то, что возвращает «прошло / не прошло». Claude останавливается, когда работа выглядит готовой; если проверить её нечем, тестировщиком становитесь вы. Когда проверка есть, агент сам вносит правку, запускает её, читает вывод и исправляет ошибку до следующего запуска.
Проверкой может быть почти что угодно, лишь бы агент мог прочитать результат: файл тестов, код выхода сборки, линтер, скрипт, который сравнивает вывод с эталоном, скриншот браузера рядом с макетом. Строже или мягче — решаете вы:
Четыре уровня проверки в Claude Code (по документации Anthropic)
Где задана проверка
Как выглядит
Кто решает, что готово
В промпте
«run the auth tests after, and keep going until they pass»
Сам Claude
Цель /goal
«/goal all tests in tests/auth pass and lint is clean»
Отдельная модель после каждого хода
Хук Stop
Скрипт с кодом выхода 2 не даёт закончить ход, пока, например, не пройдёт tsc --noEmit
Claude Code (детерминированно)
Ревью
/code-review в новом субагенте, который не видел ваш разговор
Второй взгляд без предвзятости автора
При любом уровне просите доказательства: команду, которую агент запустил, и её вывод, либо скриншот. Фраза «все тесты прошли» сама по себе мало что говорит, а прочитать вывод быстрее, чем перезапускать проверку. OpenAI в разделе о коде предупреждает о том же: инструмент вроде apply_patch может ответить «Done» даже при сбое, поэтому патчи нужно перепроверять.
Отдельная ловушка — подгонка под тесты. Для неё у Anthropic есть готовый фрагмент системного промпта: попросить общее решение для всех допустимых входов, запретить зашитые значения под конкретные тесты и сообщать, если тест сам ошибочен. В формулировке гайда тесты нужны, чтобы проверить правильность решения, и само решение должно следовать из требований задачи.
CLAUDE.md, AGENTS.md и GEMINI.md: что записать один раз
Claude Code загружает CLAUDE.md в каждую сессию, поэтому каждая строка файла немного отвлекает агента на любой задаче. Документация советует записывать туда только то, что нельзя вычитать из кода:
Как проверить работу в этом репозитории: точные команды тестов, typecheck и линтера, запуск одного файла тестов.
Места, где код вводит в заблуждение: старый паттерн, который встречается повсюду, но копировать его нельзя.
Решения, которых нет в репозитории: какой хелпер ошибок выбрала команда, как устроен деплой.
Всё, что пришлось исправлять дважды.
# Commands
- Install: pnpm install
- Run one test file: pnpm vitest run path/to/file.test.ts
- Typecheck: pnpm tsc --noEmit

# Conventions
- Use the error helpers in src/lib/errors.ts, never throw raw strings

# Gotchas
- Integration tests need DATABASE_URL set, see .env.example
Это пример из документации Anthropic. Стартовую версию генерирует команда /init, гайд по памяти советует держать файл короче 200 строк, а /context показывает, загрузился ли он. Правило, которое не должно нарушаться ни разу («никогда не читать .env», «не трогать папку migrations»), Anthropic советует выносить из CLAUDE.md в хук или deny-правило: модель следует строке файла почти всегда, а хук срабатывает всегда.
У Google аналог — файлы GEMINI.md в Gemini CLI: глобальный в ~/.gemini/GEMINI.md и проектные в рабочих папках и их родителях, команды /memory show и /memory reload. Имя файла меняется настройкой context.fileName, например на AGENTS.md, чтобы один файл читали разные агенты. Для бесплатного тарифа и Google One с 18 июня 2026 года Gemini CLI заменён на Antigravity CLI.
Если вы собираете своего агента через API, поведение по умолчанию задаётся системным промптом. В гайде Anthropic по промптингу есть готовые фрагменты под типичные проблемы агентного кодинга. Их стоит брать как есть и проверять на своих задачах:
Проблема и фрагмент системного промпта из гайда Anthropic
Проблема
Что добавить в системный промпт
Агент придумывает, что написано в коде
Блок investigate_before_answering: не рассуждать о коде, который агент не открывал, и читать файл, на который ссылается пользователь, до ответа
Лишние файлы, абстракции и «улучшения»
Фрагмент против over-engineering: менять только то, что попросили или что явно необходимо; без хелперов для разовых операций и обработки невозможных сценариев
Подгонка под тесты
Общее решение для всех допустимых входов, без зашитых значений; сообщать, если тест некорректен
Длинная задача на несколько сессий
Статус тестов в JSON (например, tests.json), заметки о прогрессе в progress.txt, git как журнал и точки отката
Временные скрипты остаются в проекте
Просьба удалить временные файлы и хелперы в конце задачи
Рискованные действия
Список действий, требующих подтверждения: удаление файлов и веток, git push --force, сообщения и пуш кода, видимые другим
Сам фрагмент против выдумок выглядит так (текст из документации Anthropic):
<investigate_before_answering>
Never speculate about code you have not opened. If the user references a specific file, you MUST read the file before answering. Make sure to investigate and read relevant files BEFORE answering questions about the codebase.
</investigate_before_answering>
OpenAI для задач с кодом советует похожий набор: роль агента-инженера, правила использования инструментов выполнения кода и случаи, когда их не трогать (например, без интерактивного запуска без необходимости), конкретные примеры вызова команд и аккуратный Markdown, где пути к файлам, функции и классы оформлены обратными кавычками. Для продакшена OpenAI отдельно советует закреплять конкретный снапшот модели и держать набор тестов и evals до любой правки промпта. Как собрать такой набор, разобрано в уроке «Оценка промптов: LLM-as-judge и тест-харнессы».
Function calling в Claude: описание инструмента — тоже промпт
Когда вы передаёте в API список tools, Claude выбирает инструмент по его названию и описанию. Документация Anthropic по tool use называет подробное описание «самым важным фактором» качества работы с инструментами. В описании должно быть: что делает инструмент, когда его вызывать и когда нет, что значит каждый параметр, какие есть ограничения. Ориентир — минимум 3–4 предложения на инструмент.
{
  "name": "get_stock_price",
  "description": "Retrieves the current stock price for a given ticker symbol. The ticker symbol must be a valid symbol for a publicly traded company on a major US stock exchange like NYSE or NASDAQ. The tool will return the latest trade price in USD. It should be used when the user asks about the current or most recent price of a specific stock. It will not provide any other information about the stock or company.",
  "input_schema": {
    "type": "object",
    "properties": {
      "ticker": { "type": "string", "description": "The stock ticker symbol, e.g. AAPL for Apple Inc." }
    },
    "required": ["ticker"]
  }
}
Это «хороший» пример из документации. В «плохом» описание состоит из одной фразы «Gets the stock price for a ticker.», и у модели остаётся много вопросов. Ещё четыре правила оттуда же:
Сложные входы — с примерами. Поле input_examples принимает примеры вызова, каждый проверяется по схеме, невалидный даёт ошибку 400. Простой пример стоит около 20–50 токенов промпта.
Меньше инструментов, больше возможностей у каждого. Вместо create_pr, review_pr и merge_pr — один инструмент с параметром action.
Префикс сервиса в имени: github_list_prs, slack_send_message — выбор однозначен, когда инструментов много.
tool_choice принимает auto (по умолчанию), any, tool и none. Для Claude Opus 5.5 и Sonnet 5.5 значения any и tool возвращают ошибку 400: документация советует auto вместе со strict tool use или structured outputs.
Первый запрос к API начинается с установки SDK: pip install anthropic (нужен Python 3.10 или новее) и ключа в переменной ANTHROPIC_API_KEY. Пошагово это разобрано в бесплатном уроке «Первые шаги: установка и первый запрос», а весь цикл с инструментами — в курсе «Tool use в Claude: function calling на Python» (6 уроков, от первого инструмента до чатбота с несколькими).
Что больше не нужно писать в промптах для кода
В документации Claude Code есть отдельный раздел о советах, которые устарели вместе со старыми моделями. Коротко:
Старые привычки и что делать сейчас (Best practices for Claude Code)
Привычка
Что изменилось
IMPORTANT и КАПС для важных строк
Текущие модели следуют спокойной формулировке, а избыток акцентов заставляет применять правило где не надо. Жёсткое правило — в хук или deny-правило
«think hard», «be thorough»
Глубину задаёт effort; такие фразы лишь подталкивают модель в его пределах. ultrathink просит глубокое рассуждение на один ход
«Продолжай, пока не закончишь, не ленись»
Модели и так доводят согласованную задачу; такие строки скорее приводят к лишней работе. Проверка с «прошло / не прошло» по-прежнему полезна
Описывать архитектуру в CLAUDE.md
Claude читает репозиторий сам; записывать нужно только то, чего в нём нет
Агрессивно экономить контекст
У большинства текущих моделей окно 1 млн токенов и автоматическое сжатие; /clear между задачами всё ещё полезен
У Google похожий совет для Gemini 3: просить модель расписывать шаги рассуждения в ответе обычно не нужно, а для по-настоящему сложной задачи может помочь короткая просьба подумать тщательнее — ценой дополнительных токенов. Для длинного контекста порядок тот же, что у Anthropic: сначала весь код и документы, вопрос в самом конце. Примеры (few-shot) Google советует добавлять всегда и держать в одном формате.
Где отработать: курсы Academl по промптам для кода
Чтение гайдов даёт словарь, навык появляется на своих задачах. В курсах ниже каждый урок заканчивается практическим заданием, решение проверяет ИИ и даёт разбор, есть квиз и ИИ-тьютор, после всех уроков — сертификат с кодом проверки.
Курсы по промптам для кода: объём и что отработаете
Структура и роли, ограничения вывода, ReAct, adversarial-тесты, оценка промптов, промпты в проде
Сроки. При 30 минутах в день и 5 днях в неделю курс по Claude Code проходится примерно за 2 недели, «ИИ для кода» — за один вечер. Реальный темп зависит от того, сколько времени уходит на задания на своём проекте.
Цена. Первые 2 урока каждого курса открыты бесплатно, после регистрации 7 дней полного доступа ко всему каталогу без карты, дальше Pro — $9 в месяц или $79 в год (тарифы). Сам Claude Code оплачивается отдельно, через подписку Claude или аккаунт Anthropic Console. Если выбираете между редактором и агентом, начните со статьи «Cursor vs Claude Code»; полный маршрут для разработчика собран в треке «AI для разработчика», а общий план обучения промптам — в статье «Промпт-инжиниринг с нуля: план на 4 недели».
Частые вопросы
Чем промпт для кода отличается от обычного промпта?
У промпта для кода есть обязательная часть: проверка результата. Anthropic советует дать агенту то, что возвращает «прошло / не прошло» (тест, сборку, линтер, скрипт сравнения с эталоном), и просить команду с её выводом. OpenAI в гайде по коду тоже требует проверять изменения тестами.
Где официальная документация по промптам для кода?
У Anthropic это страницы Best practices for Claude Code (code.claude.com) и Prompting best practices (platform.claude.com), у OpenAI — раздел Coding в гайде Prompt engineering, у Google — Prompt design strategies для Gemini API. Ссылки на все три собраны в этой статье.
Нужно ли писать «думай шаг за шагом» в промпте для Claude Code?
По документации Claude Code такие фразы — обычный текст промпта. Глубину рассуждения задаёт уровень effort, а «думай шаг за шагом» лишь слегка подталкивает модель в пределах этого уровня. Слово ultrathink по-прежнему просит более глубокое рассуждение на один ход.
Что писать в CLAUDE.md?
Только то, что агент не найдёт в коде: точные команды тестов, typecheck и линтера, места, где код вводит в заблуждение, решения команды и то, что приходилось исправлять дважды. Anthropic советует держать файл коротким, а правила без исключений переносить в хуки и deny-правила.
Как писать описание инструмента для function calling в Claude?
Anthropic называет подробное описание главным фактором качества: что делает инструмент, когда его вызывать и когда нет, что значит каждый параметр, какие есть ограничения. Ориентир — минимум 3–4 предложения на инструмент, для сложных входов можно добавить input_examples.
Работает ли tool_choice any в Claude Opus 5.5?
Для Claude Opus 5.5 и Sonnet 5.5 значения any и tool в tool_choice возвращают ошибку 400. Документация советует оставить auto и включить strict tool use, чтобы входы инструмента точно соответствовали схеме, или использовать structured outputs.
Где научиться промптам для кода на практике?
В Academl это курс «Claude Code и агентная разработка» (10 уроков), часовой курс «ИИ для кода» и курс по tool use в Claude. Первые 2 урока каждого курса бесплатны, после регистрации 7 дней полного доступа без карты, затем Pro за $9 в месяц или $79 в год.